⬅ Voltar para a página principal
🔗 Índice
🧬 Metagenômica e Microbiomas - Métodos computacionais
O termo “microbioma” geralmente é utilizado para se referir à composição complexa de genes e genomas de microrganismos associados a ambientes, hospedeiros, tecidos e superfícies. Um dos grandes desafios na análise de microbiomas gerados por sequenciamento WGS é a atribuição de uma quantidade massiva de sequências a classes taxonômicas e funcionais. A principal metodologia utilizada para a classificação das sequências baseia-se na homologia de proteínas. Nessa abordagem, as sequências de nucleotídeos são traduzidas e alinhadas contra um banco de dados de referência de proteínas com identidade taxonômica e funcional conhecidas. Em seguida, os alinhamentos significativos resultantes são usados para atribuir as sequências a grupos taxonômicos e funcionais baseando-se em pontuações similares aos resultados gerados pelo BLAST. Tradicionalmente, as análises de microbiomas usam os bancos de proteínas como referência (Bağcı et al. 2021), que são mais conservadas do que as sequências nucleotídicas. Isso significa que é mais provável encontrar sequências similares em proteínas do mesmo táxon, mesmo que haja variações nas sequências de DNA. Além disso, uma compreensão biológica das vias metabólicas presentes em um determinado microbioma requer conhecimento detalhado das proteínas com função conhecida, o que permite uma melhor inferência funcional. Desta forma, diversos programas que analisam microbiomas gerados por WGS, tem como abordagem central o alinhamento das sequências traduzidas do microbioma contra o banco de dados NR do NCBI (Sayers et al. 2025). Algoritmos otimizados foram desenvolvidos mais recentemente para dar maior rapidez aos alinhamentos, sem perder a precisão da atribuição taxonômica.
O programa DIAMOND, por exemplo, é amplamente utilizado em análises metagenômicas. Ele é um alinhador otimizado para a estratégia seed-extend, que utiliza um alfabeto reduzido para a correspondência entre as queries e o banco de dados (Buchfink et al. 2015) e permite que o usuário altere parâmetros de especificidade e pontuação de alinhamentos, como no BLAST. Após o alinhamento, a atribuição taxonômica e funcional é feita pelo script MEGANIZER, implementado no programa MEGAN6 (Huson et al. 2016).
Nesta aula, vamos usar conjuntos de dados metagenômicos de sequências curtas geradas em plataforma Illumina. As amostras foram sequenciadas com a metodologia de shotgun e, para as análises vamos utilizar os programas DIAMOND e MEGAN6. Estes programas são adequados para a análise de grandes conjuntos de dados (dezenas de milhões de reads) e permitem realizar uma abordagem comparativa dos microbiomas. A análise consiste nos seguintes passos principais:
-
- Alinhamento de todos os reads gerados contra o banco de dados de proteínas NR (NCBI), usando o DIAMOND (passo realizado no servidor).
-
- Atribuição taxonômica e funcional dos alinhamentos resultantes usando o programa MEGANIZER do MEGAN6 (passo realizado no servidor).
-
- Exploração dos dados interativa usando o MEGAN6 (no seu computador).
Após o alinhamento e a atribuição taxonômica e funcional feita em um servidor, é possível analisar os dados em um computador com menor poder de processamento. Devido à restrição do poder computacional dos desktops no LIG, vamos usar os dados processados em um servidor, mas todos os passos da análise serão simulados em aula.
💎 1. DIAMOND - Alinhamento de sequências metagenômicas geradas por shotgun
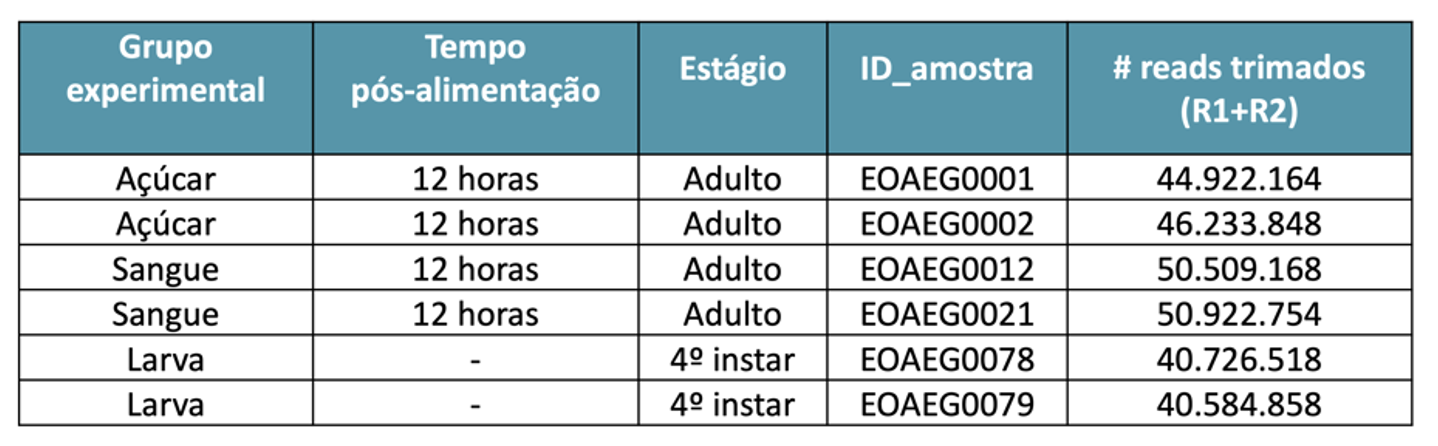
Os conjuntos de dados que vamos utilizar foram gerados na plataforma Illumina em uma corrida paired-end. Cada arquivo analisado tem, em média, 45 milhões de reads com 251 bases de comprimento (Tabela 1).
Tabela 1. Número de reads de cada amostra.
Para realizar o alinhamento das sequências, é necessário usar o comando do DIAMOND juntamente com os parâmetros obrigatórios da análise.
- O comando
diamondchama o programa. - Em seguida, precisamos especificar o algoritmo de alinhamento. Como temos sequências de DNA e queremos alinhá-las a um banco de referência de proteínas, usaremos o
blastx. - O alinhamento deve ser feito usando um banco de dados de referência com sequências indexadas e classificadas, como o banco de sequências de proteínas nr, do NCBI. Este parâmetro obrigatório da análise é determinado com o argumento
-d nr. - O arquivo de entrada (input), que contém as sequências, deve ser especificado com o argumento
-q input.fastq. - Para os arquivos de saída (output), é importante indicar a extensão do “diamond alignment archive”, ou DAA, que especifica que este é o arquivo resultante dos alinhamentos do DIAMOND. Para isso, é preciso adicionar ao comando o parâmetro
-o output.daae usar o argumento-f 100, que formatará o output corretamente como DAA. Este formato é necessário para o passo de conversão do alinhamento posteriormente, com o programa MEGANIZER, permitindo que ele possa ser visualizado graficamente no MEGAN6. - Outros argumentos e parâmetros do DIAMOND podem ser observados com o comando de ajuda
diamond help.
Sabendo destas informações, agora podemos montar a linha de comando que será utilizada nas análises:
diamond blastx -d nr -q amostra.fastq -o amostra.daa -f 100
Lembre-se que você deve usar os paths (endereços) completos dos programas e dos arquivos que não estão na variável $PATH ou no mesmo diretório que você dispara a análise.
📊 2. MEGANIZER – classificação taxonômica e funcional
O programa DIAMOND gera um arquivo em formato DAA que contém as sequências alinhadas e seus respectivos alinhamentos. Estas informações são úteis para realizar a atribuição taxonômica e funcional (binning) das sequências. O programa MEGANIZER atua justamente neste passo, agrupando sequências e escrevendo um bloco adicional de resultados no final do arquivo DAA gerado no output do passo anterior.
Para os reads curtos, o agrupamento taxonômico é feito usando o algoritmo naïve LCA (lowest common ancestor), com base na taxonomia do NCBI e do Genome Taxonomy Database (GTDB) (Huson et al. 2016). A atribuição funcional é realizada pela estratégia do melhor alinhamento (best hit) (Mitra et al. 2011), usando a classificação de vários bancos curados de proteínas como referência (EC, eggNOG, InterPro2GO, SEED).
Para realizar a classificação taxonômica e funcional, é necessário usar o programa MEGANIZER com um arquivo de mapeamento - MEGAN MAP. O arquivo DAA gerado pelo DIAMOND pode ser “meganizado” com a seguinte linha de comando:
daa-meganizer -i nome_do_arquivo.daa -mdb path/para/megan-map-Feb2022.db -t 30
-i indica o arquivo de entrada/input (ou seja, o arquivo .daa gerado no passo anterior).
-mdb indica o endereço do arquivo de mapeamento para classificação taxonômica e funcional, que inclui as informações dos bancos de dados NCBI, GTDB, EC, eggNOG, InterPro2GO, SEED.
-t 30 é o argumento que paraleliza o processamento do arquivo (em 30 CPUs, neste exemplo). O número pode variar de acordo com a disponibilidade de CPUs e o default é 8.
Ao fim do processo, o arquivo DAA terá três blocos de informação de dados:
- informação de identificação das proteínas de referência encontradas (headers) no seu conjunto de sequências;
- todas as sequências alinhadas e todos os alinhamentos realizados contra as proteínas de referência;
- um bloco de informações adicionadas pelo MEGANIZER com as classificações taxonômicas e funcionais, juntamente com um índice de todos os reads alinhados.
O novo arquivo DAA “meganizado” pode ser aberto diretamente no programa MEGAN6.
🦣 3. MEGAN6
O MEGAN6 é um programa que permite a visualização e exploração interativa de conjuntos de dados de metagenomas em desktops. Ao ser iniciado, o programa abre duas janelas. A janela principal mostra uma árvore com a taxonomia definida pelo banco Taxonomy do NCBI. A janela secundária exibe um log de todos os comandos executados durante as análises e eventuais erros.
Para abrir um arquivo DAA já “meganizado” ou um arquivo já exportado no formato .megan, clique em File ▸ Open e então escolha o arquivo a ser analisado. Você deve escolher um dos arquivos que estão em formato .megan no diretório aula_03. O programa irá mostrar a atribuição dos reads na árvore taxonômica do NCBI. Você pode expandir ou contrair a árvore nos sentidos horizontal e vertical para visualizar melhor. A barra de status na parte inferior da janela mostra as informações sobre o número de táxons sendo mostrado e dados sobre amostra, como o número de reads analisados e atribuídos. Os parâmetros utilizados na “meganização” também podem ser visualizados na barra de status e estão resumidos abaixo:
• MinScore - limite mínimo do bitscore (default = 50.0)
• MaxExpected - limite máximo do e-value (default = 0.01)
• TopPercent - filtra os alinhamentos menos relevantes e considera apenas os que têm bitscore próximo ao melhor alinhamento. Isso é útil para reduzir a quantidade de dados redundantes e focar apenas nos alinhamentos mais informativos para cada read (default = 10.0)
• MinSupportPercent - limite mínimo da porcentagem de reads atribuídos a um determinado táxon (e seus descendentes) para que ele apareça na árvore taxonômica (default = 0.05)
• MinSupport - limite mínimo do número de reads atribuídos a um determinado táxon (e seus descendentes) para que ele apareça na árvore taxonômica
Os dois últimos parâmetros determinam que os reads atribuídos aos táxons que não atendem aos critérios devem ser contabilizados no nó imediatamente superior da árvore (em direção à raiz), até que um nível taxonômico seja alcançado com uma contagem de reads suficientemente alta.
Por padrão, os círculos representam os táxons e nós da árvore. O tamanho dos círculos corresponde à abundância relativa de cada táxon na amostra, ou seja, é proporcional ao número de reads atribuído a um determinado táxon ou nó. Quando você clica em cada círculo, pode visualizar o número de reads atribuídos àquele táxon específico (assigned) e também à soma dos reads atribuídos a todos os táxons descendentes daquele nó (summed).
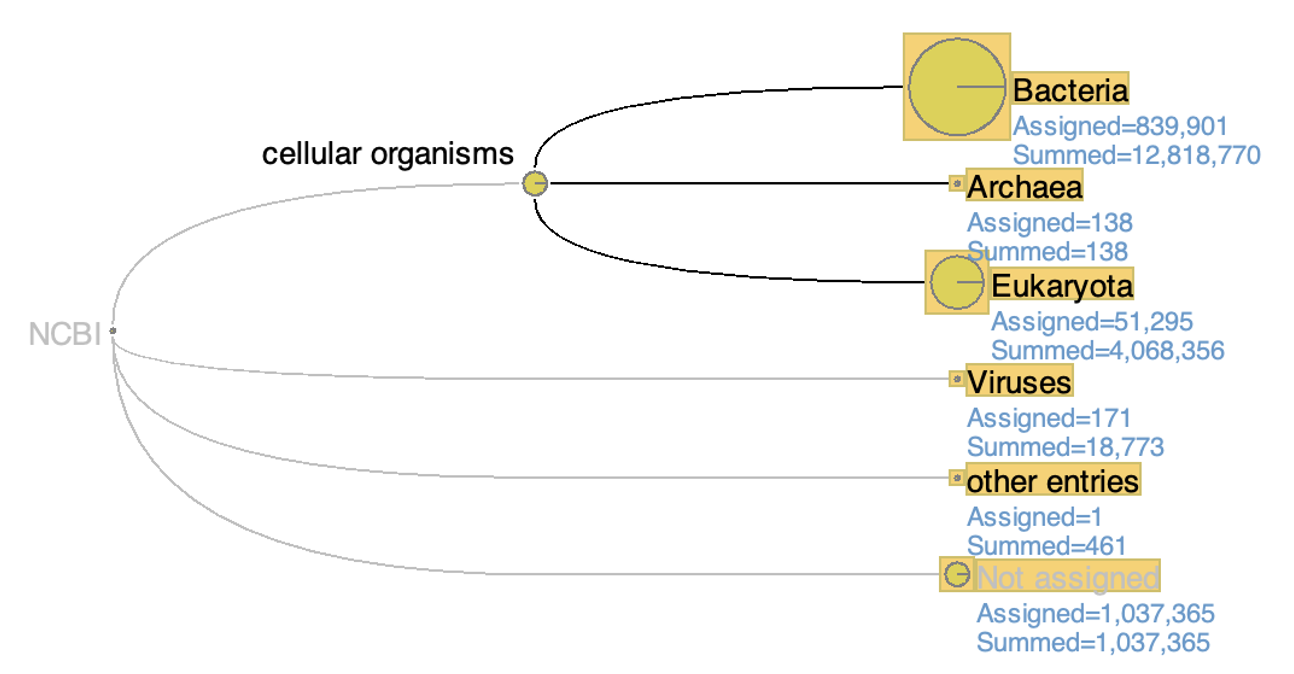
Você pode colapsar ou expandir os nós para interagir com seus resultados, escolhendo o nível taxonômico que deseja visualizar.
- ▶️ Clique no botão
Ranke explore os dados, escolhendo o nível taxonômico que deseja visualizar.
Para facilitar a visualização das abundâncias relativas dos organismos identificados na sua amostra, vamos criar um gráfico no nível taxonômico que você escolher. As folhas da árvore taxonômica precisam estar selecionadas para isso. A seleção é feita automaticamente quando você escolhe o ranqueamento taxonômico com o botão Rank.
- ▶️ Para gerar o gráfico, clique em
Show chartna barra de ferramentas e escolhaShow Bubble Chart, ouShow Stacked Bar Chart. Uma nova janela vai abrir com o gráfico e você pode ordenar os táxons por ordem crescente ou decrescente do número de reads clicando no menu à esquerda.
Os gráficos abaixo estão em nível taxonômico de Filo.
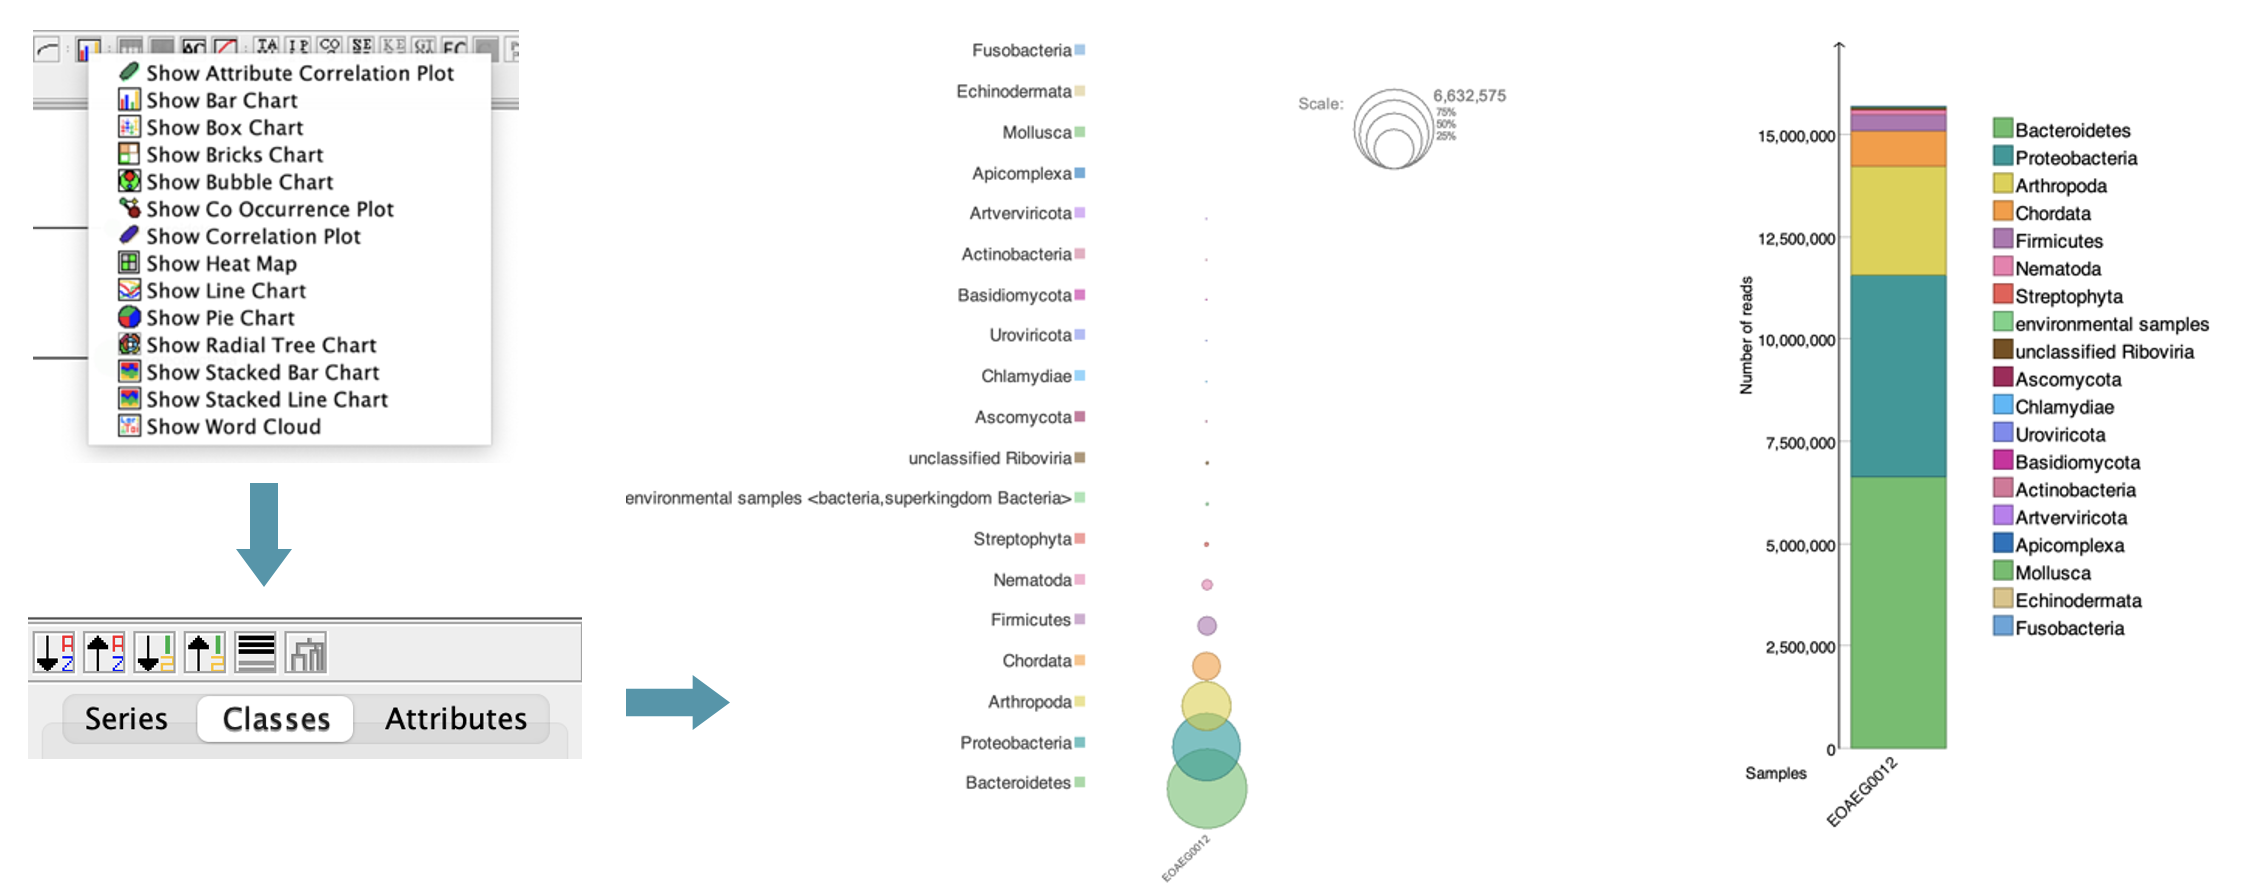
- ❓ Qual o filo mais abundante na sua amostra?
- ❓ Qual a espécie mais abundante na sua amostra?
🧫 4. Análise de Diversidade
As análises de diversidade de comunidades microbianas permitem avaliar a heterogeneidade taxonômica encontrada em amostras, além de indicar se a distribuição de espécies nas amostras ocorre uniformemente. Em alguns casos, a homeostase de sistemas pode ser avaliada a partir de índices de diversidade, sendo, portanto, uma medida indicativa das condições boas ou ruins de tecidos, órgãos ou mesmo do ambiente. A diversidade do microbioma pode ser avaliada por meio de múltiplos índices ecológicos, que podem ser divididos em dois tipos de medidas: diversidade alfa e diversidade beta (Calle 2019). A diversidade alfa mede a variabilidade das espécies dentro de uma amostra, enquanto a diversidade beta considera as diferenças na composição microbiana entre as amostras.
4.1. Diversidade Alfa
Os índices de diversidade alfa quantificam a variabilidade de espécies encontradas em uma amostra e incluem tanto os métodos que estimam a riqueza de espécies (richness) a partir do número observado de táxons únicos em uma amostra, como também os índices que levam em consideração o número de espécies e suas abundâncias relativas (richness + evenness), de forma a indicar se as espécies estão uniformemente distribuídas em uma amostra.
O índice de Shannon (H) é um dos índices de diversidade mais utilizados em estudos metagenômicos. Ele considera tanto a riqueza quanto a uniformidade da distribuição de espécies em uma amostra. Quanto maior o valor do índice de Shannon, maior a diversidade na amostra. Ele pode variar de zero a um valor máximo que depende do número de espécies e da equitabilidade da distribuição de espécies (se há dominância de poucas espécies ou não). Quanto maior o número de espécies presentes e quanto mais uniforme for a distribuição de indivíduos entre elas, maior será o valor do índice de Shannon. Uma amostra com um único táxon terá H = 0 (amostra não diversa). Para interpretar o valor do índice de Shannon, é importante compará-lo com os valores de outras amostras da mesma população ou do mesmo ambiente.
Para calcular a riqueza observada de espécies e o índice de diversidade da amostra que você está analisando no MEGAN6, você deve escolher o nível taxonômico que quer realizar a análise. Como estamos interessados na comunidade microbiana presente nas amostras, os reads atribuídos ao hospedeiro não são interessantes. Ao mesmo tempo, os reads atribuídos aos fungos e Archaea são irrisórios na comparação com aqueles atribuídos às bactérias. Por isso, vamos usar apenas as bactérias como representativos do microbioma que estamos analisando.
Para realizar o cálculo do número observado de espécies:
- ▶️ Marque a opção
Tree ▸ Keep Non-Prokaryotes Collapsed - ▶️ Selecione o nó referente a Bacteria na árvore e clique no botão
Rank ▸ Species. Todas as folhas da árvore com espécies atribuídas estarão selecionadas. -
▶️ Agora clique em
Show Chart ▸ Bubble Chart. A barra de status da janela irá indicar o número de espécies bacterianas (Classes) - ❓ Quantas OTUs em nível taxonômico de espécie tem a sua amostra?
- ❓ Compare a riqueza da sua amostra com a de outros grupos
Agora, para realizar o cálculo do índice de diversidade alfa, siga os seguintes passos:
- ▶️ Certifique-se de que a opção
Tree ▸ Keep Non-Prokaryotes Collapsedestá marcada ✔️ - ▶️ Clique no botão
Rank ▸ Species - ▶️ Escolha o índice de diversidade a ser calculado em
Options ▸ Shannon-Weaver Index
O cálculo será feito levando em consideração a riqueza e a distribuição dos reads atribuídos às diferentes espécies e o resultado será mostrado na janela de log do MEGAN6.
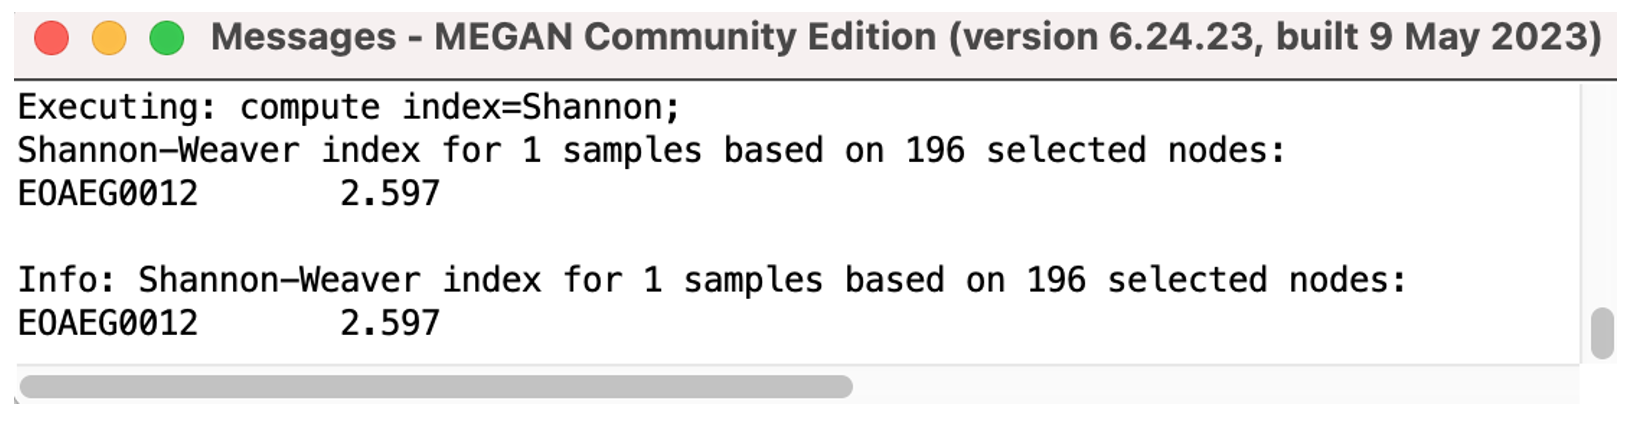
- ❓ Qual a diversidade encontrada na sua amostra?
- ❓ Como ela se compara às diversidades encontradas nas outras amostras analisadas pelos grupos?
- ❓ O índice de diversidade mudou a sua percepção de como a sua amostra se compara às dos demais grupos?
4.2. Diversidade Beta
A diversidade beta quantifica a diferença na composição das comunidades biológicas entre amostras. Originalmente, a diversidade beta foi definida como a razão entre a diversidade global encontrada nas amostras (diversidade gama) e a diversidade local (diversidade alfa) (Whittaker 1972). Atualmente, a maioria das métricas de diversidade beta é baseada em medidas de dissimilaridade, sendo que a dissimilaridade de Bray-Curtis e a distância de UniFrac (Lozupone et al. 2007) são os índices mais utilizados em análises metagenômicas.
Para realizar o cálculo da diversidade beta, vamos utilizar a dissimilaridade de Bray-Curtis, cujo cálculo está implementado no MEGAN6. Este índice leva em consideração a abundância dos táxons em cada amostra e a distância é calculada para cada par de amostras. Uma matriz de distância é gerada, que pode ser visualizada em forma de um gráfico de coordenadas principais (PCoA), também conhecido como escalonamento multidimensional (MDS). O PCoA produz um conjunto de eixos não correlacionados (ortogonais) para resumir a variabilidade no conjunto de dados. Cada eixo possui um valor, cuja magnitude indica a quantidade de variação capturada nesse eixo (Buttigieg & Ramette 2014). A distância entre os pontos no gráfico representa a distância entre as amostras, calculadas na matriz. A interpretação de um gráfico de PCoA é direta: objetos ordenados próximos uns dos outros são mais similares do que aqueles ordenados mais distantes.
A diversidade beta é uma medida comparativa entre as amostras, por isso um novo arquivo precisa ser gerado a partir do processamento de todos os arquivos das amostras individuais. Para isso, abra todos os arquivos .megan que estão no diretório aula_03. Quando todos estiverem carregados:
- ▶️ Clique em
File ▸ Compare.
Uma nova janela vai abrir, com a lista de todos os arquivos abertos. Para criarmos um arquivo com todas as amostras, siga os seguinte passos:
- ▶️ Clique no botão
Select All - ▶️ Escolha a opção ✔️ Use Normalized Counts e ✔️ Ignore all unassigned reads
- ▶️ Clique no botão
Apply
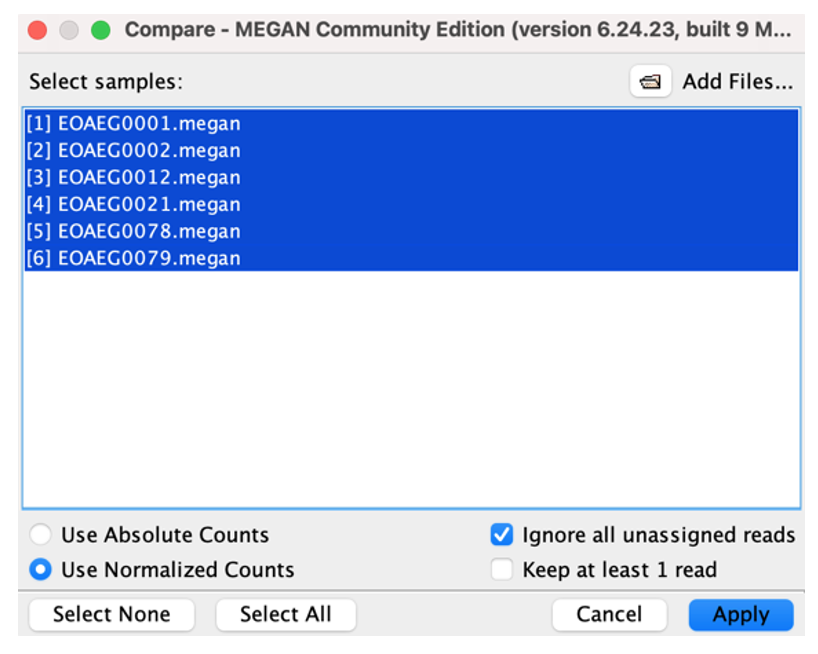
Após o processamento de todas as amostras, uma nova janela vai abrir com a árvore taxonômica, mas agora com a comparação das seis amostras que estamos analisando. Salve o arquivo com as amostras comparadas e feche os outros arquivos para evitar uso desnecessário de memória e CPU no seu computador.
Para calcular a diversidade beta das amostras, siga as seguintes instruções:
- ▶️ Certifique-se de que a opção
Tree ▸ Keep Non-Prokaryotes Collapsedestá marcada ✔️ - ▶️ Clique no botão
Ranke escolha o nível taxonômicoSpecies -
▶️ Agora clique no botão
Open a cluster analysis windowna barra de ferramentas - ❓ O que a PCoA da diversidade beta indica sobre as amostras individuais e sobre os grupos experimentais?
🔍 5. Análise comparativa
Com o arquivo comparativo gerado, agora é possível também comparar o perfil taxonômico das amostras e revelar padrões específicos de composição dos microbiomas de diferentes grupos experimentais. Para gerar um gráfico comparativo, siga os seguintes passos:
- ▶️ Certifique-se de que a opção
Tree ▸ Keep Non-Prokaryotes Collapsedestá marcada ✔️ - ▶️ Clique no botão
Ranke escolha o nível taxonômicoPhylum - ▶️ Clique no botão
Show Charte escolhaStacked Bar Chart - ▶️ Para ordenar o gráfico por ordem decrescente de reads atribuídos, clique na aba de
Classesno menu à esquerda e então no botão para ordenação decrescente dos reads
- ▶️ Escolha o gráfico que indica a porcentagem atribuída de reads
- ❓ Todas as amostras tem a mesma composição de Filos bacterianos?
- ❓ Quais filos são característicos de cada grupo experimental?
Agora repita os mesmos passos acima, mas para o nível taxonômico de espécies (Rank ▸ Species).
- ❓ Quais são as espécies mais abundantes em cada grupo experimental?
- ❓ Procure informações sobre estas espécies bacterianas que estão colonizando os grupos experimentais
📈 6. Rarefação
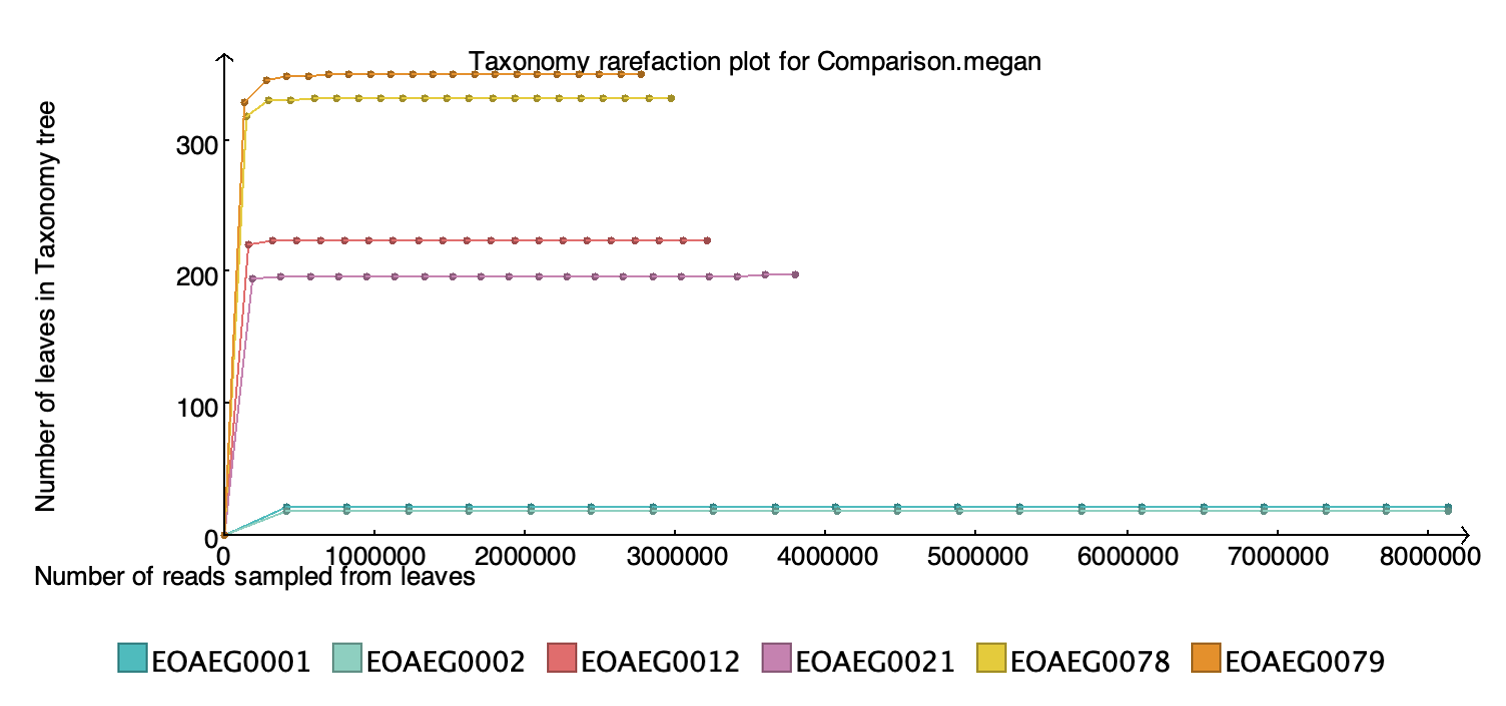
A rarefação é uma medida que indica se as amostras foram sequenciadas com profundidade suficiente para de fato serem utilizadas como uma medida da diversidade da comunidade microbiana. Nas análises de rarefação, a riqueza de espécies (ou a diversidade alfa) é calculada em subamostras de reads e serve como uma medida da identificação redundante de táxons no seu conjunto de dados. Quando seus dados foram exaustivamente sequenciados, a curva de rarefação atinge um plateau, indicando que a amostragem de novos reads contribui muito pouco para a descoberta de novas espécies na amostra. Quando o plateau não é atingido, suas análises de diversidade e identificação taxonômica podem estar subestimando a presença de microrganismos da comunidade, principalmente as espécies mais raras. Portanto, a profundidade de sequenciamento é fundamental para a rarefação.
-
▶️ Calcule a rarefação clicando no menu
Window ▸ Rarefaction Analysis. -
❓ Qual a sua conclusão sobre a diversidade do microbioma das amostras como função da profundidade de sequenciamento?
ℹ️ Quer saber mais sobre de ordenação e análises estatísticas aplicadas a estudos de microbiomas? Acesse o GUSTA ME (Buttigieg & Ramette 2014).
⬅ Voltar para a página principal
📖 Referências
- Bağcı C, Patz S, Huson DH. 2021. DIAMOND+MEGAN: Fast and Easy Taxonomic and Functional Analysis of Short and Long Microbiome Sequences. Curr Protoc. 1:e59. doi: 10.1002/cpz1.59.
- Buchfink B, Xie C, Huson DH. 2015. Fast and sensitive protein alignment using DIAMOND. Nat Methods. 12:59–60. doi: 10.1038/nmeth.3176.
- Buttigieg PL, Ramette A. 2014. A guide to statistical analysis in microbial ecology: a community-focused, living review of multivariate data analyses. FEMS Microbiol Ecol. 90:543–550. doi: 10.1111/1574-6941.12437.
- Calle ML. 2019. Statistical Analysis of Metagenomics Data. Genom Informatics. 17:e6. doi: 10.5808/gi.2019.17.1.e6.
- Huson DH et al. 2016. MEGAN Community Edition - Interactive Exploration and Analysis of Large-Scale Microbiome Sequencing Data. PLoS Comput. Biol. 12:e1004957. doi: 10.1371/journal.pcbi.1004957.
- Lozupone CA, Hamady M, Kelley ST, Knight R. 2007. Quantitative and Qualitative β Diversity Measures Lead to Different Insights into Factors That Structure Microbial Communities. Appl. Environ. Microbiol. 73:1576–1585. doi: 10.1128/aem.01996-06.
- Mitra S et al. 2011. Functional analysis of metagenomes and metatranscriptomes using SEED and KEGG. BMC Bioinformatics. 12:S21-9. doi: 10.1186/1471-2105-12-s1-s21.
- Sayers EW et al. 2025. Database resources of the National Center for Biotechnology Information in 2025. Nucleic Acids Res. 53:D20–D29. doi: 10.1093/nar/gkae979.
- Whittaker RH. 1972. Evolution and measurement of species diversity. Taxon. 21:213–251. doi: 10.2307/1218190.