⬅ Voltar para a página principal
🔬 FastQC - Análise da qualidade das sequências
Os sequenciadores de nova geração geram reads no formato fastq, que contém a informação da chamada da base nucleotídica em cada sítio (basecalling) juntamente com o valor de qualidade da chamada. A qualidade das bases reflete um valor de confiança associado a uma probabilidade de erro de leitura. Este valor é codificado no arquivo fastq e programas como o FastQC podem decodificar estes valores em gráficos e informações que ajudam no controle de qualidade dos dados gerados em plataformas de nova geração. Cada teste recebe um status (pass, warning ou fail) e desta forma é possível avaliar a qualidade dos dados que você possui para dar prosseguimento (ou não) às análises do seu projeto. Para um conjunto de dados de sequências gerados em plataforma Illumina, o valor da qualidade associada à probabilidade de erro é dado de acordo com a tabela abaixo:
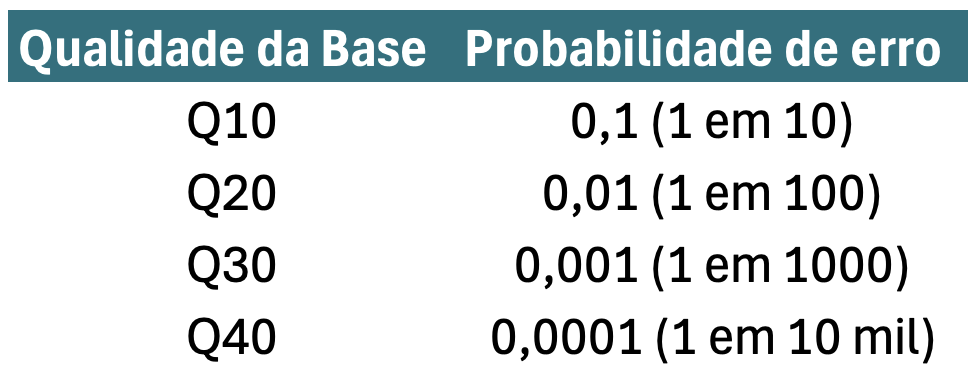
Para avaliar a qualidade dos dados de sequenciamento que iremos usar neste curso, vamos usar o programa FastQC, já instalado no seu computador. Para isso, use o seguinte comando:
micromamba activate metodos
E então execute o FastQC com o comando:
fastqc
Quando o programa abrir, siga o seguinte protocolo:
1. Clique no Menu File▸Open
2. Escolha o arquivo illumina.fastq na pasta aula_01.
Este arquivo contém uma subamostra do conjunto de dados total (que é muito grande). Os resultados serão abertos em uma aba, contendo a sinalização verde (dados normais), laranja/amarela (resultados um pouco anormais) ou vermelha (não usuais)
3. Analise as estatísticas básicas: quantidade de sequências, tamanho das sequências e porcentagem GC
4. Agora avalie a qualidade de cada base (basecalling) no gráfico boxplot. A linha vermelha em cada box é o valor mediano da qualidade. A barra amarela representa a amplitude interquartil (25-75%) dos valores de qualidade. As linhas superior e inferior representam os pontos de 10% e 90% dos dados. A linha azul representa a qualidade média das bases em cada posição do read. O que você pode dizer sobre os reads baseando-se nestes resultados?
5. Avalie a qualidade de sequência gerada por tile. Esta análise é disponível somente para dados da plataforma Illumina e indica o desvio da qualidade média dos reads ao longo da flowcell. Desta forma, é possível visualizar se houve uma perda de qualidade associada a algumas regiões da flowcell ou se o sequenciamento foi homogêneo em toda flowcell. As cores variam da escala fria 🥶 azul para quente 🥵 vermelha em ordem decrescente de qualidade. Ou seja, cores frias indicam boa qualidade e cores quentes indicam uma qualidade ruim.
6. O gráfico de qualidade por sequência gerada ajuda a entender como a corrida de sequenciamento se comportou, indicando o número de reads com um determinado Q-score.
7. O gráfico do conteúdo de bases por sequência indica a proporção de bases A, T, C e G chamadas ao longo dos reads. Em uma biblioteca aleatória, espera-se que pouca diferença seja detectada entre diferentes bases, mas as alterações nas frequências nucleotídicas podem indicar uma característica biológica da amostra sendo sequenciada, como sequências super-representadas ou regiões de repetição. Alterações nas frequências de bases nas extremidades dos read podem ocorrer quando bibliotecas são geradas com a ligação de primers randômicos ou são feitas por tagmentação (mediada por transposase).
8. O conteúdo GC dos reads na biblioteca é plotado em um gráfico que mede a distribuição normal a partir dos dados sequenciados. Esta informação pode ser especialmente valiosa quando picos muito diferentes são visualizados, indicando uma possível contaminação ou mistura de organismos. O módulo pode indicar um alerta quando o desvio da distribuição normal representa 15% dos reads ou acusar falha quando for superior a 30% dos reads. Lembre-se que o desvio também pode ser uma característica biológica do genoma analisado (concentração de reads ricos em GC ou AT em uma parte do genoma, por exemplo).
9. O conteúdo de bases “N” se refere às bases que não foram adequadamente detectadas pelo sistema de imagem do sequenciador. A substituição de qualquer base por um N indica que nenhuma das bases pôde ser detectada com confiança suficiente e é um erro no basecalling. O número de Ns em uma sequência é um fator importante para as análises seguintes e influencia na qualidade global do read.
10. O gráfico de distribuição do tamanho das sequências irá traduzir o tamanho dos fragmentos da biblioteca e/ou o tamanho máximo dos reads gerados na plataforma. Para a plataforma Illumina, é normal o gráfico com um pico nos tamanhos de 101, 151, 251 ou 301 bases (a depender da plataforma).
11. O módulo de análise de sequências duplicadas indica a quantidade de reads idênticos gerados na biblioteca. O resultado pode indicar um alto nível de cobertura de um determinado genoma (regiões sequenciadas com redundância) ou algum viés na construção ou enriquecimento da biblioteca. É esperado que em bibliotecas suficientemente diversas, a maior parte das sequências esteja à esquerda do gráfico. Em caso de enriquecimento de bibliotecas, algumas regiões podem estar super-representadas e por isso picos ao longo da curva podem ocorrer. O módulo também calcula a perda de reads em caso de deduplicação (remoção dos reads duplicados).
12. As sequências super-representadas na biblioteca podem ser visualizadas no módulo de análise overrepresented sequences, que lista as sequências com mais de 0,1% de frequência.
13. A análise do conteúdo de adaptadores indica a presença (ou não) dos mesmos nas sequências. Várias plataformas utilizam a ligação de adaptadores durante a construção das bibliotecas e eles são sequenciados juntamente com a sequência de interesse. É comum realizar um pós-processamento das sequências com programas para remover os adaptadores, bases e reads com baixa qualidade (Trimmomatic, Cutadapt, fastp, BBDuk são muito utilizados). Quando há detecção de adaptadores nos reads, o gráfico sempre os colocará no final e a porcentagem sempre aumentará no fim da curva, quando presentes.
14. Se você quiser, pode salvar os reports em formato html clicando em File▸Save Report.
ℹ️ Quer saber mais informações sobre os parâmetros das análises realizadas pelos módulos do FastQC? Clique aqui.
ℹ️ O formato FASTQ
A ordem das informações de um read em formato .fastq tem o seguinte significado:
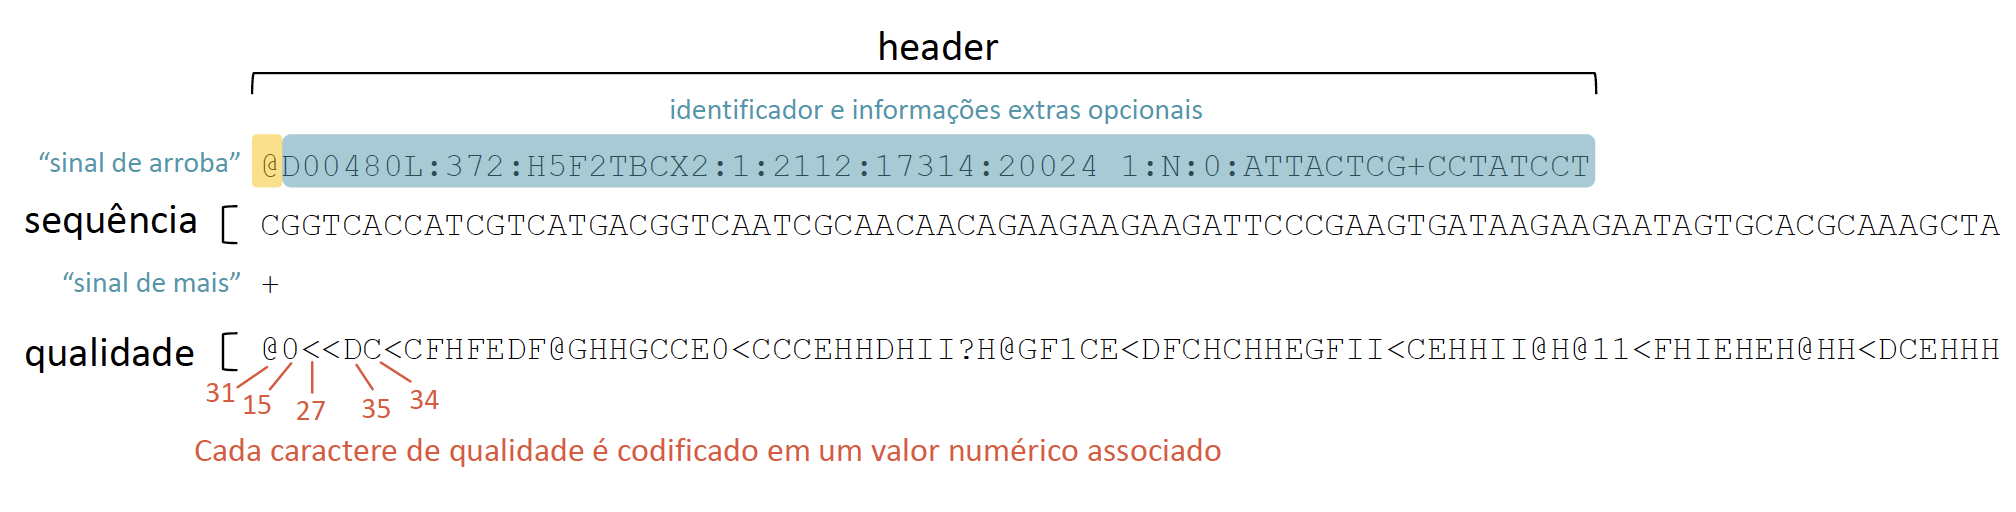
A qualidade das bases é codificada em ASCII (American Standard Code for Information Interchange). Para entender a correlação da codificação da qualidade da chamada de bases, clique aqui.