⬅ Voltar para a página principal
🔎 Anotação
Após a montagem de genomas, é possível avaliar suas características estruturais e sua organização, mas para analisar as características funcionais, é necessário realizar o passo de anotação. O processo de anotação de um genoma permite identificar, nomear e estabelecer a localização de cada característica relevante na sequência genômica de uma espécie.
Geralmente, a anotação inclui as coordenadas de regiões codificadoras de proteínas e seus produtos, assim como a localização de genes de RNAs estruturais. No entanto, é possível adicionar camadas de informação à anotação básica e incluir isoformas de um gene codificador de proteína, RNAs regulatórios, regiões de ligação de peptídeos, conteúdo GC e até mesmo variações encontradas em populações de uma espécie.
Para eucariotos, o processo de anotação pode ser demorado e exige que modelos gênicos sejam treinados previamente para cada espécie, utilizando conjuntos de dados de transcriptomas e proteomas do organismo (ou de espécies próximas) para a validação dos genes preditos computacionalmente. Procariotos possuem organização e estrutura de genes mais simples do que espécies eucarióticas e diversos programas para predição gênica têm sido desenvolvidos para agilizar o processo de anotação em larga escala, permitindo que funções e redes metabólicas sejam acessadas com rapidez e acurácia.
Com o advento das tecnologias de sequenciamento de nova geração, conjuntos de dados em escala genômica passaram a ser gerados rapidamente a um custo mais baixo. Particularmente, a obtenção de sequências de genomas bacterianos passou a ser rotineira em alguns laboratórios, uma vez que têm aplicações importantes na agricultura, ciências ambientais, saúde pública e indústria. Os genomas bacterianos completos ou quase completos são amplamente utilizados para inferir relações evolutivas e revelar as bases genéticas de características biológicas, como virulência, resistência a antimicrobianos e potencial metabólico.
Neste módulo, iremos utilizar o programa Prokka para anotar as características funcionais no genoma montado a partir de dados metagenômicos (MAG - metagenome-assembled genome). Este programa pode ser utilizado na linha de comando, mas recentemente foi implementado em um módulo de análise online no Proksee (Seemann 2014; Grant et al. 2023), facilitando a anotação e a visualização simultâneas de genomas bacterianos. Estes programas coordenam uma variedade de softwares existentes para obter uma anotação rica e confiável de sequências genômicas bacterianas.
Para a anotação, as proteínas codificadas pelos genes preditos pelo Prokka são anotadas em duas etapas: primeiramente, o Prokka faz uso do programa Prodigal (Hyatt et al. 2010), que identifica as coordenadas dos genes candidatos identificando códons de iniciação e de terminação no genoma, além de realizar um escaneamento dos quadros de leitura abertos (ORFs) para realizar as predições de genes.
As regiões gênicas costumam ser comparadas a grandes bancos de dados para validar as sequências e transferir a anotação para o genoma de interesse, mas o Prokka refina esse procedimento de maneira hierárquica, começando com bancos de dados com menos sequências, mas todas curadas, identificadas e usadas como referências. O programa expande as análises para bancos de dados de médio porte, específicos para domínios de proteínas. Finalmente, a busca de similaridade é feita para modelos curados de famílias de proteínas.
Por padrão, o limiar de valor de e-value é de 10⁻⁵ para o BLAST contra os seguintes bancos de dados:
- UniProt, que possui transcritos e proteínas completas (não fragmentadas);
- Todas as proteínas de genomas bacterianos completos depositados no RefSeq do NCBI;
- PFAM e TIGRFAMs para a identificação de famílias de proteínas.
Além dessa rotina para identificação de genes codificadores de proteínas, o Prokka ainda utiliza:
- Barrnap para anotar os genes de RNA ribossomal (rRNA),
- Aragorn para a predição dos genes de RNA transportador (tRNA),
- SignalP para detecção de peptídeos sinais na região N-terminal,
- Infernal para a predição de RNAs não codificadores (ncRNAs).
Se nenhum match for encontrado, mas houver evidência da predição computacional do gene, então a região é anotada como “hypothetical protein”.
🧪 Anotação e visualização no Proksee:
- Acesse o portal do Proksee em: https://proksee.ca
- Clique em Browse e faça o upload do arquivo FASTA da montagem do genoma que está no diretório
aula_04. - Clique no botão Create Map.
- A janela que será carregada terá uma figura circular do genoma.
- No menu à direita, dentro do submenu Genome Annotation, clique no botão Start da ferramenta Prokka.
- Uma janela irá aparecer em que você pode escolher um nome para sua análise. Os parâmetros da análise devem ser:
- Kingdom = Bacteria
- Genus = Other
- Genetic Code = Bacterial and Plant Plastid
Clique em OK para iniciar a análise.
- Uma janela com os logs do programa vai indicar o passo que está sendo rodado. Ao final, uma janela do relatório final será gerada, indicando o Prokka Report.
- Agora clique em Add Features to Map, para visualizar as anotações no genoma, e então em OK.
-
Uma janela com o mapa genômico anotado irá aparecer.
Salve as mudanças feitas para não perder os resultados em caso de algum erro, clicando no botão Save Changes, que fica na parte superior direita da janela.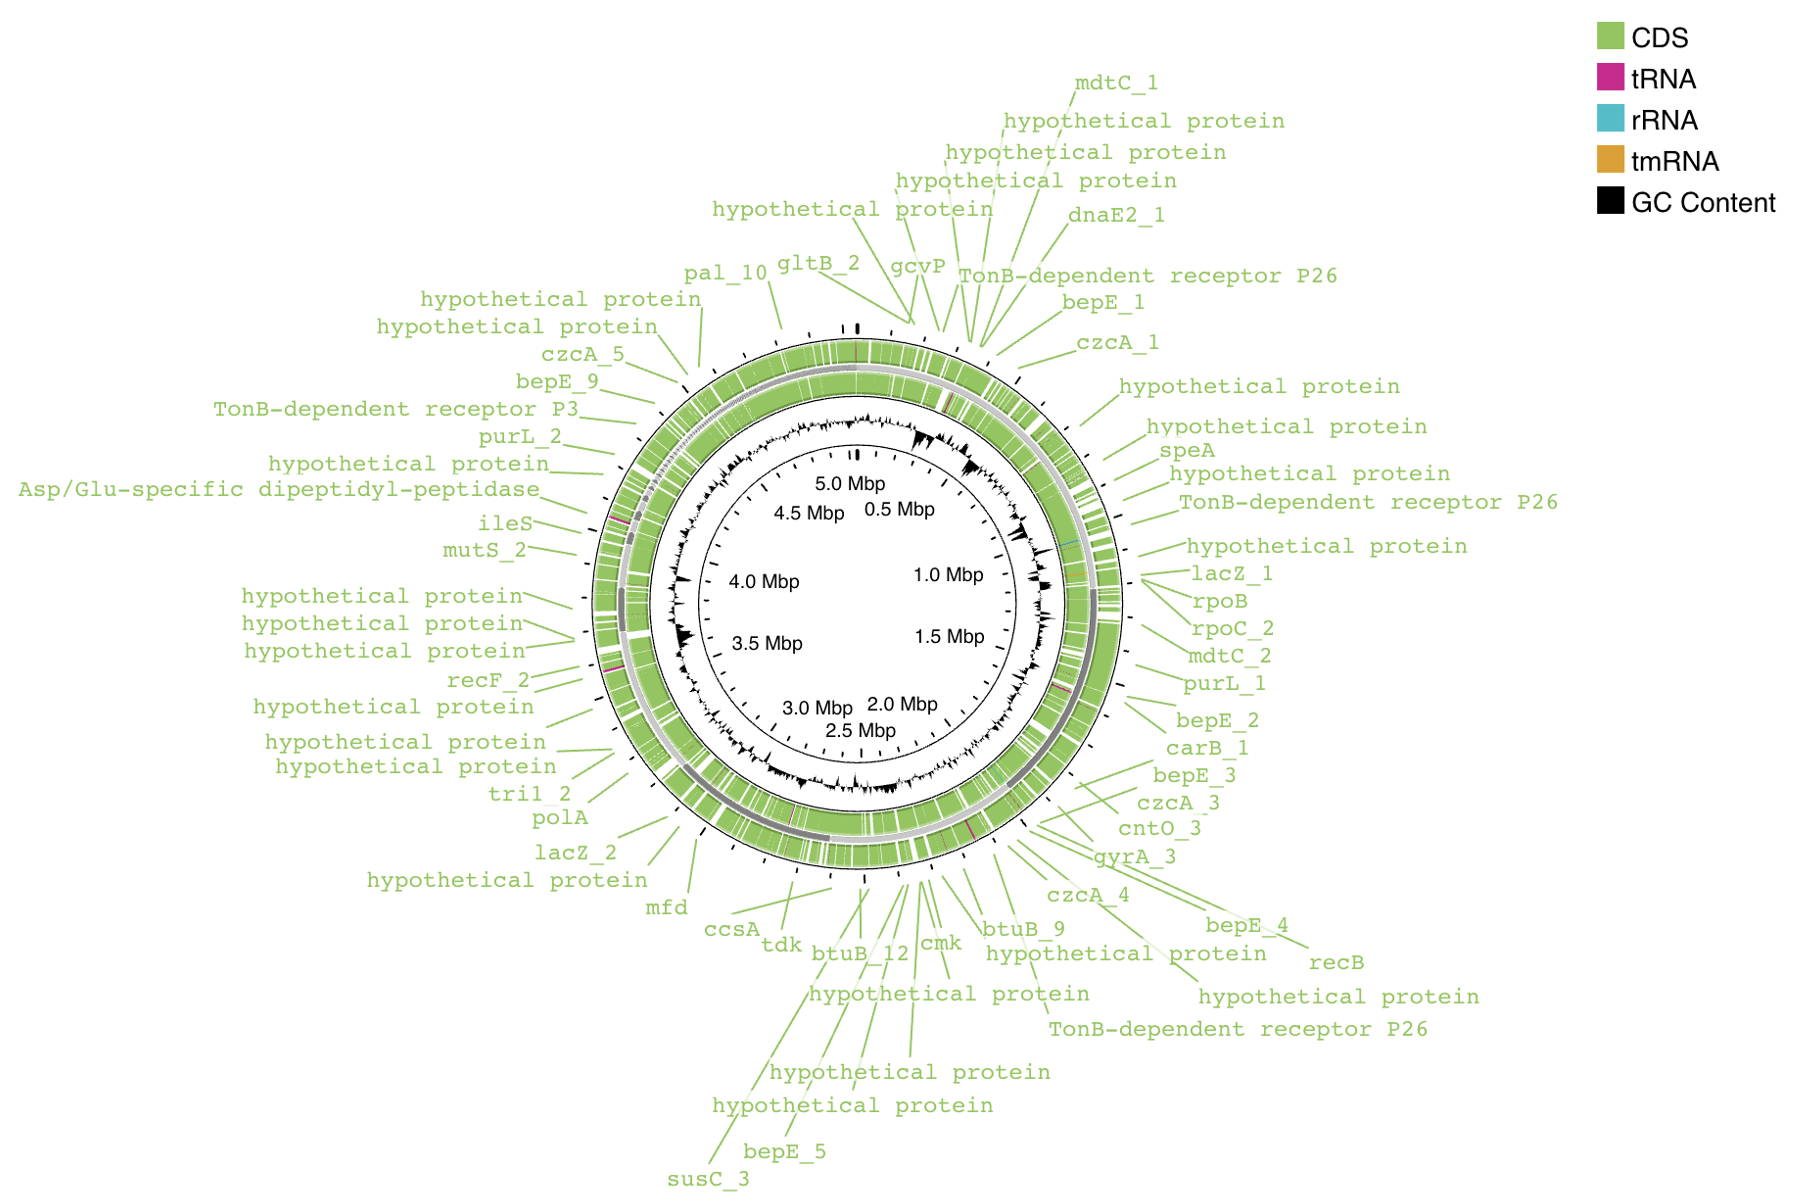
- Você pode procurar por características específicas deste genoma. Clique no menu Regions, então em Features. Uma lista com todas as características anotadas no genoma irá aparecer. Qual o principal tipo de característica (feature) anotada neste genoma?
-
Você consegue saber quantos CDS, tRNAs e rRNAs foram anotados neste genoma?
📌 Dica: use a lupa para buscar características específicas usando o tipo de característica (Type)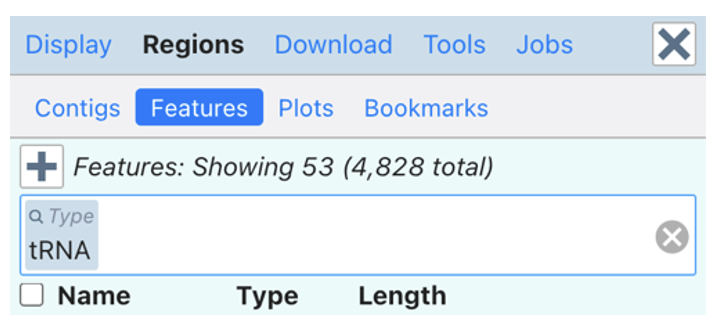
-
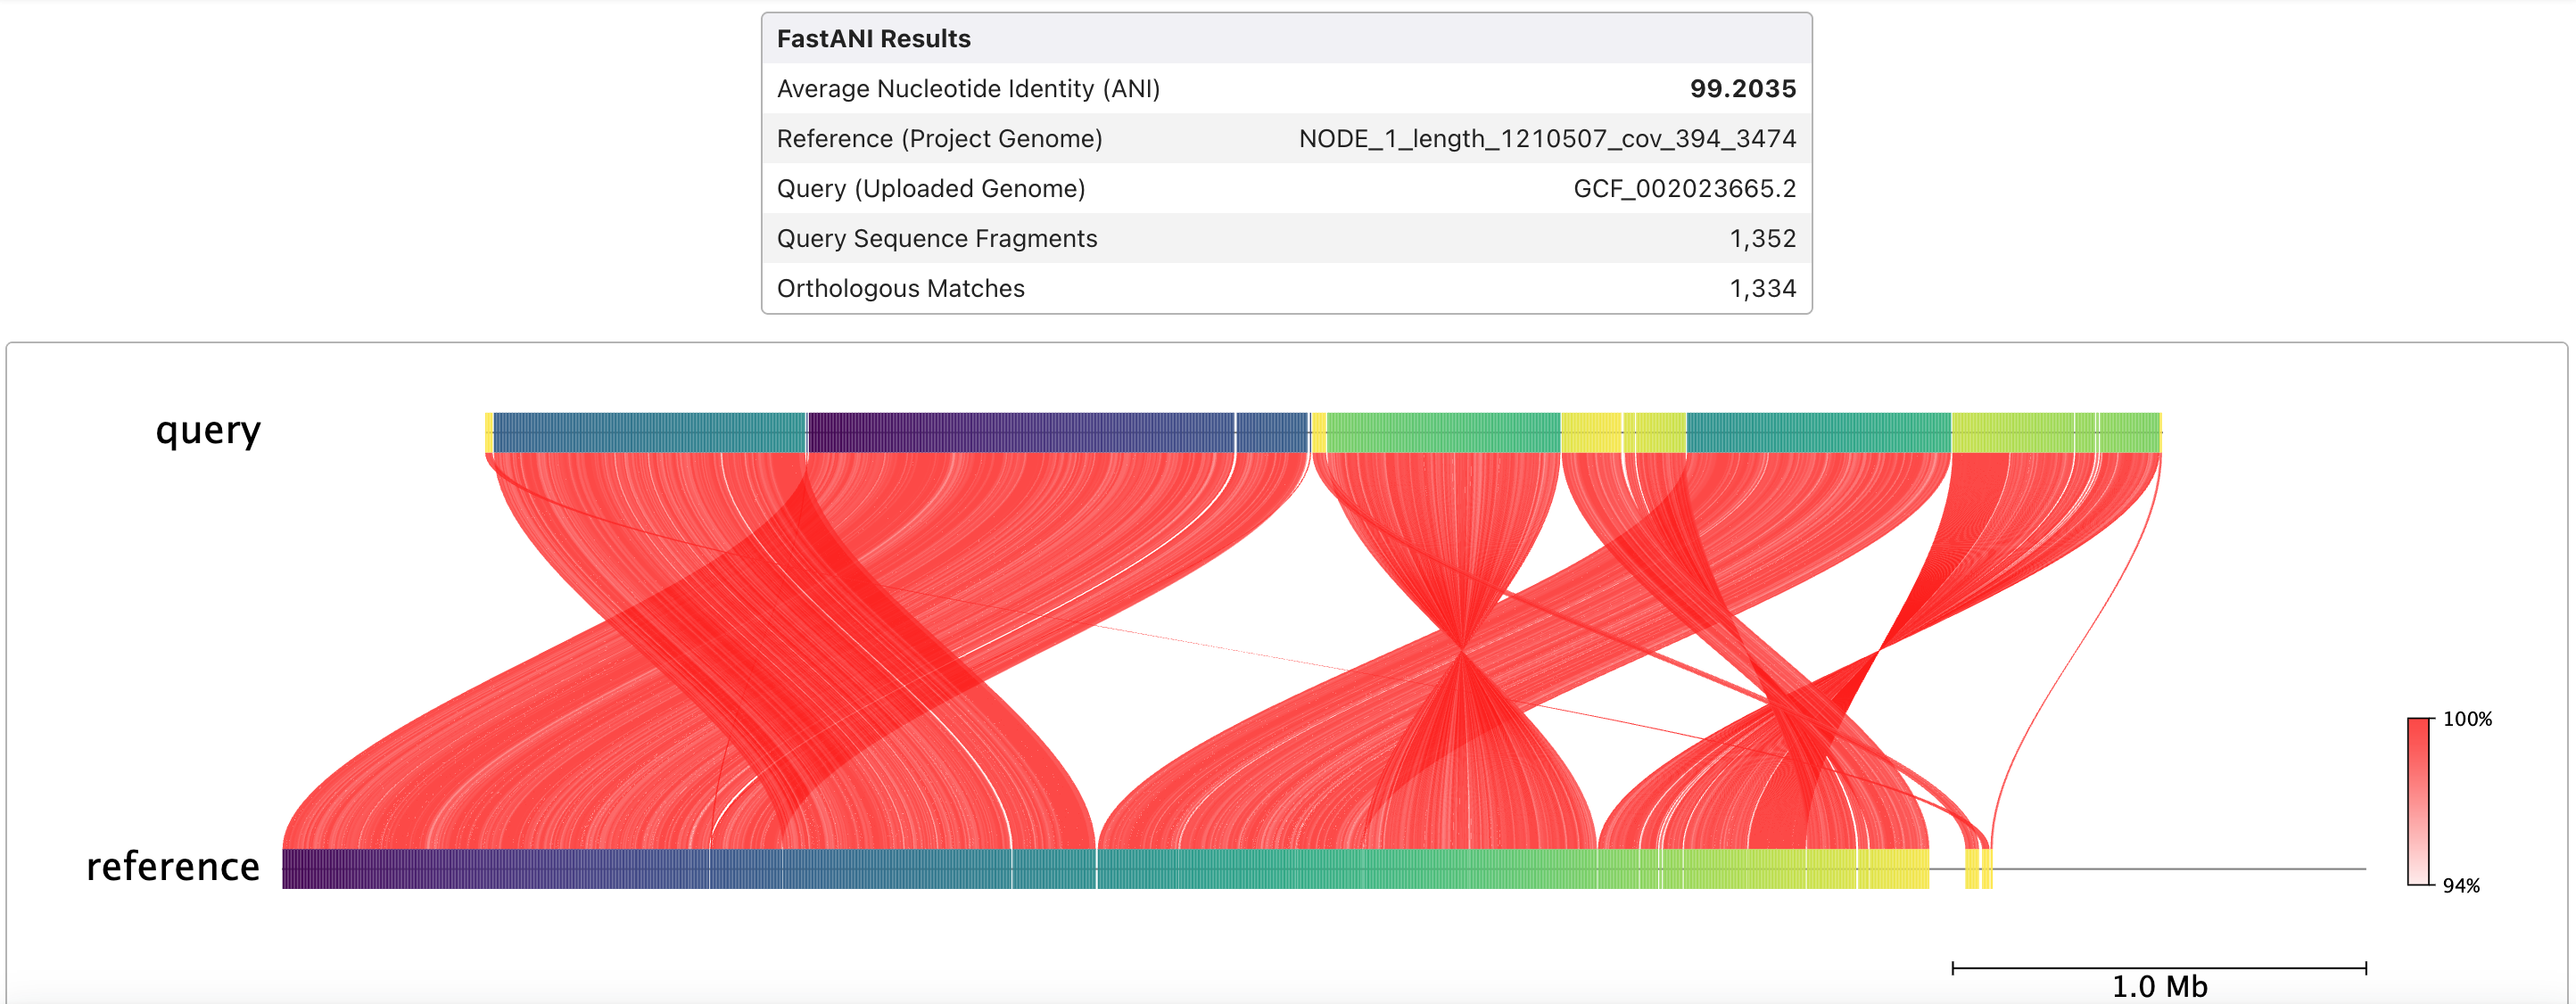
Agora vamos comparar a identidade do genoma montado com o genoma de referência da espécie Elizabethkingia anophelis. Volte para o menu Tools e no submenu Sequence Comparison, clique no botão de Start da ferramenta FastANI. No campo Query, insira o número de acesso do genoma de referência de E. anophelis (linhagem R26): GCF_002023665.2. Clique em OK e analise os resultados.
- Se você quiser fazer o download da figura do seu genoma anotado, clique no menu Data e então na aba Download.
⬅ Voltar para a página principal
📖 Referências
- Grant JR, Enns E, Marinier E, et al (2023) Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. https://doi.org/10.1093/nar/gkad326
- Hyatt D, Chen G-L, LoCascio PF, et al (2010) Prodigal: prokaryotic gene recognition and translation initiation site identification. BMC Bioinform 11:119. https://doi.org/10.1186/1471-2105-11-119
- Seemann T (2014) Prokka: rapid prokaryotic genome annotation. Bioinformatics 30:2068 2069. https://doi.org/10.1093/bioinformatics/btu153